
 admin
AI聽不懂你的母語?34億人的多語言AI、低資源語言與下一場數位落差
全球AI公司現在正在比:
- 模型有多聰明
- 推理能力有多強
- AI代理人能不能自己完成工作
- 圖片與影片能不能生成得更真
但2026年9月21日,一群科技公司、研究機構、政府與非營利組織提出了一個更基礎的問題:
如果AI根本不熟悉你的語言,再強的模型和你又有什麼關係?
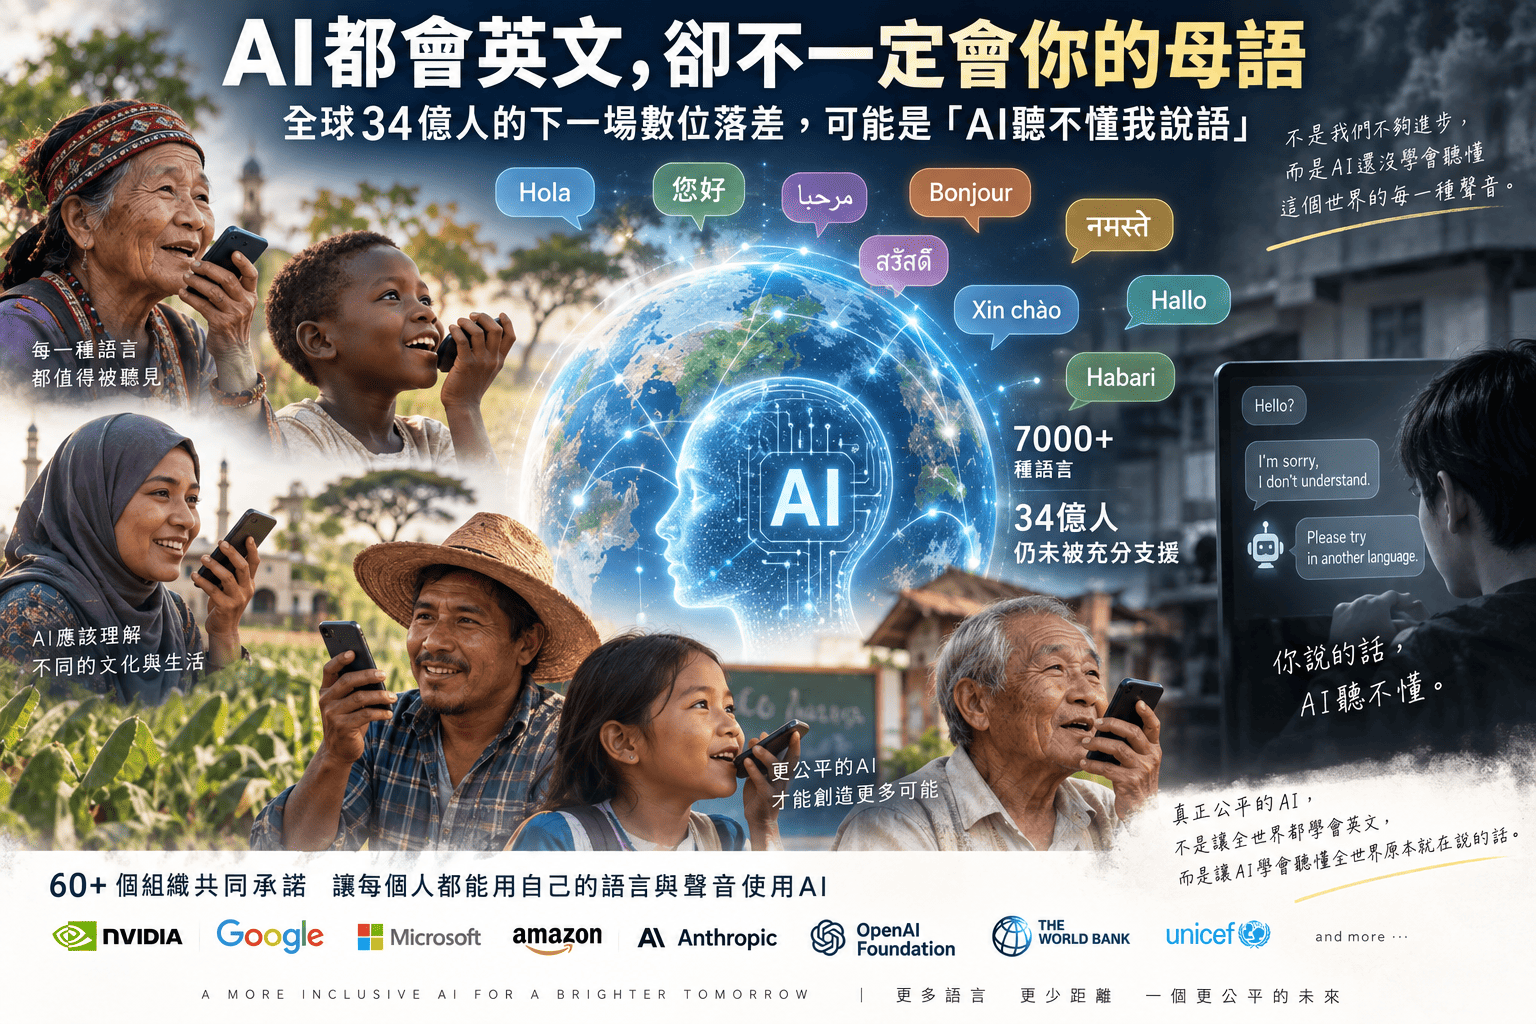
蓋茲基金會公布一項為期5年的全球共同承諾,由60個首批簽署組織參與,包括NVIDIA、Google、Microsoft、Amazon、Anthropic、OpenAI Foundation、ElevenLabs、Mozilla Data Collective、世界銀行與UNICEF等。
共同目標是:
未來5年,讓估計約34億名使用目前AI模型中代表性不足語言的人,可以直接用自己的語言與聲音使用AI。
這個數字幾乎接近全球人口的一半。
而真正的問題不是這34億人完全沒有智慧型手機,也不是每個人都完全無法連網。
而是他們即使可以打開AI,也可能必須先換成:
- 英文
- 法文
- 西班牙文
- 中文
- 其他模型資料更豐富的主流語言
才能比較容易得到自然、完整、可靠的答案。
下一場AI數位落差,可能正在從「有沒有AI可以用」,變成「AI到底會不會我的語言」。
全球大約有7000種語言,但真正有足夠資料訓練高品質AI的只是一小部分
蓋茲基金會指出,全球大約有7,000種語言,但真正擁有足夠數位資源,可以支援強大AI能力的只占少數。
大量語言都屬於所謂:
Low-resource languages,低資源語言
「低資源」並不一定代表使用這種語言的人很少,也不代表它在文化或社會上不重要。
它更接近一個數位資料概念。
也就是這種語言缺少足夠的:
- 文字語料
- 高品質翻譯資料
- 語音錄音
- 詞典與語言工具
- 人工標註資料
- 模型評測基準
問題就在於:
AI不是天生就懂所有語言,它是從資料裡學會語言。
如果某種語言在網路上有大量:
- 新聞
- 書籍
- 百科
- 論壇
- 程式文件
- 影音字幕
而另一種語言主要存在於家庭、地方社群與口語交流中,兩種語言最後得到的AI能力自然很難完全相同。
「支援100種語言」和「真的理解100種語言」其實完全是兩件事
現在很多多語言AI產品都會標示:
- 支援中文
- 支援印地語
- 支援阿拉伯語
- 支援數十種甚至上百種語言
但「可以輸入」只是最基礎的一層。
真正的語言能力還包含:
- 能不能理解不同口音
- 能不能處理地方方言
- 能不能理解俚語
- 能不能處理慣用語與雙關
- 能不能掌握文化脈絡
- 能不能理解同一個詞在不同地區的不同意思
這次全球語言AI共同承諾特別提醒,方言、俚語、慣用語與文化脈絡都可能改變句子的真正意思。
在聊天場景裡翻譯錯一句話可能只是尷尬,但在醫療、教育、金融與公共服務中,語意錯誤可能帶來實際後果。
所以真正應該問的不是:
「語言選單裡有沒有這個名字?」
而是:
這個AI在這種語言、這種口音、這種任務上的表現到底有多可靠?
AI為什麼特別擅長英文?因為網路本來就不是全球語言人口的等比例縮影
大型AI語言模型的訓練資料大量來自數位世界。
包括:
- 網站
- 書籍
- 新聞
- 百科全書
- 論壇
- 開源資料庫
但全球網路內容本來就高度不平均。
某些語言擁有數十年的:
- 數位出版
- 線上新聞
- 百科內容
- 論壇討論
- 技術文件
其他語言卻可能主要存在於:
- 家庭對話
- 地方廣播
- 口述傳統
- 未被數位化的地方知識
美聯社針對這項新聯盟的報導也指出,現代AI模型常大量依賴網路來源,而這些資料並不能完整代表所有文化與地區,因此可能產生文化理解與翻譯上的偏差。
AI的語言不平等,很大一部分其實是把原本網路世界的不平等重新學了一次。
真正最難的可能不是文字,而是語音:同一種語言可能有幾十種口音
這也是此次共同目標特別強調:
Own language and voice
不是只有自己的語言,還包括自己的聲音。
原因很簡單。
對全球很多人來說,打字並不是最自然的AI入口。
有些使用情境可能面臨:
- 識字程度不同
- 鍵盤輸入不方便
- 沒有一致的數位輸入習慣
- 使用功能型手機
- 網路連線不穩
這時候直接說話,反而比打字更實際。
但語音AI又比文字多出另一層困難。
同一句話可能受到:
- 口音
- 方言
- 語速
- 年齡
- 聲音特徵
- 背景噪音
影響辨識。
模型「看得懂這種文字」,不代表它「聽得懂所有真正說這種語言的人」。
OpenAI Foundation也把低資源語言工作先指向語音,因為這裡的資料缺口特別大
OpenAI Foundation在加入此次共同承諾時表示,提升低資源語言中的模型能力,將成為其工作重點之一。
第一階段尤其會著重:
- 語音AI資料
- 語音基礎建設
- 商業投資較不足的語言
這個方向也反映一個很重要的現實:
如果完全依靠商業市場決定語言支援優先順序,使用人口較少、付費能力較弱或資料取得成本較高的語言,可能永遠排在後面。
語言學會了還不夠,全球還有超過30億人連可靠網路都不是理所當然
多語言AI還碰到另一個現實:
硬體與網路。
Google近期在「AI for every language」計畫中指出,全球仍有超過30億人無法可靠取得網路服務。
這代表即使AI翻譯和語言能力解決了,如果AI仍必須:
- 使用高階智慧型手機
- 全程連接雲端
- 消耗大量網路流量
另一層數位落差仍然存在。
TranslateGemma想解決的,就是「翻譯能不能不要每次都送上雲端」
Google在2026年推出TranslateGemma,一系列建立在Gemma 3之上的開放翻譯模型,涵蓋55種語言。
其中包含較小型模型,目標之一就是讓翻譯更容易在裝置端運行。
這代表AI普及未來未必只是在比:
「誰的模型最大?」
還可能要比:
模型能不能小到讓普通設備也真的跑得動。
Google甚至把AI送進功能型手機:沒有智慧型手機,也可以直接用聲音問
但即使模型縮小了,仍然有大量人口使用的是傳統功能型手機。
Google因此支援Viamo推出「Ask Viamo Anything」,也就是AVA語音AI服務,讓一般功能型手機也可以透過語音互動使用AI。
Google表示,AVA已在盧安達既有互動式語音服務使用者中進行試點,並已使用Gemini回答超過200萬個問題。
AI普及的下一階段,不一定只是把最強模型放進最新手機,而是讓最普通的手機也有辦法接上AI。
多語言AI真正最大的市場可能不是聊天,而是醫療、農業、教育與政府服務
一個住在城市、熟悉英文的AI使用者,常見用途可能是:
- 寫信
- 做簡報
- 寫程式
- 整理資料
但對全球大量低資源語言使用者來說,AI真正有價值的場景可能完全不同。
例如農民直接用母語詢問:
「我的作物葉子變黃,可能出了什麼問題?」
孕婦可能問:
「現在這些症狀需要去醫院嗎?」
學生則可能問:
「這一道數學題到底哪一步算錯了?」
因此這次全球倡議特別把潛在應用列在:
- 醫療
- 教育
- 農業
- 金融服務
- 公共服務
在這些場景裡,如果AI只在主流語言上可靠,問題就不只是「使用比較麻煩」,而是最需要資訊的人可能根本進不來。
為什麼不能只靠AI翻譯?母語先翻成英文再問,資訊可能在中間就變形
看起來最簡單的解法是:
母語
↓
翻成英文
↓
AI理解與回答
↓
再翻回母語
但這條流程最大的問題,就是每增加一次翻譯,都多一次語意流失的可能。
尤其遇到:
- 醫療症狀
- 地方俚語
- 法律概念
- 農作物地方名稱
- 文化概念
中間語言甚至可能沒有完全對等的詞。
真正成熟的多語言AI,目標不只是每一句都先繞到英文,而是模型本身能直接理解不同語言中的問題。
要讓AI真正學會低資源語言,第一個現實難題就是:資料從哪裡來?
假設今天要訓練一套真正理解某種地方語言的AI,需要的可能包括:
- 文章
- 真實對話
- 語音錄音
- 翻譯對照
- 語音轉文字資料
- 問答資料
- 文化背景資訊
但很多低資源語言根本沒有現成的大型網路資料庫。
研究團隊可能必須另外進行:
- 訪談
- 錄音
- 人工轉寫
- 社區合作
- 建立新的評測資料
這比直接從網路取得大量主流語言資料昂貴得多。
所以這次第一項工作不是先做一個新聊天機器人,而是建立「開放語言基礎層」
此次聯盟提出四個主要工作方向。
| 方向 | 要解決的問題 |
|---|---|
| 建立開放語言層 | 建立可由AI開發者使用、具有開放授權及安全規範的共用語言資料基礎 |
| 誠實追蹤進度 | 透過評測與benchmark確認模型能力是不是真的提升 |
| 把資料變成真正工具 | 讓語言資料能進一步成為模型、應用及實際服務 |
| 安全接觸使用者 | 在隱私、同意及資料主權原則下推動資料與服務 |
換句話說,真正想做的不是每家公司各自重新收集幾千種語言一次。
而是把一部分語言資料與評測能力,逐步建立成AI生態系可以共同使用的基礎建設。
但「多收語言資料」本身也可能帶來新問題:誰同意AI拿走這些聲音與文化?
如果要建立一個少數族群語言資料庫,可能需要收集:
- 族人的聲音
- 故事
- 地方詞彙
- 文化知識
- 傳統用語
這些東西並不是單純的匿名文字。
它們可能同時是某個社群的文化資產。
因此真正的問題還包括:
- 誰同意蒐集
- 誰能使用
- 可以用於哪些模型
- 能不能退出
- 社群本身是否具有控制權
所以這次共同承諾特別把privacy、consent與data sovereignty,也就是隱私、同意與資料主權,放進核心原則。
語言資料主權未來可能變成AI治理的重要戰場:文化保存還是文化資料被抽走?
傳統個資保護比較容易想到:
- 姓名
- 電話
- 地址
- 身分資料
但語言資料還可能包括:
- 族群歷史
- 傳統故事
- 地方知識
- 傳統藥用植物名稱
- 宗教與文化概念
如果這些內容被模型大量學習,之後就可能被:
- 重新生成
- 摘要
- 翻譯
- 進一步商業利用
因此「把一種語言放進AI裡」不能只被理解成純技術問題。
它同時也是誰能控制語言資料、誰能代表這個社群,以及文化資料如何被使用的治理問題。
為什麼一定要建立評測基準?因為AI公司不能只自己說「我們支援這個語言」
此次共同承諾第二項核心工作就是:
Tracking progress honestly,如實追蹤進度。
也就是建立評測、benchmark及scorecard。
因為如果某家公司只寫:
「支援50種語言。」
消費者仍然不知道:
- 醫療問答正確率如何
- 語音辨識如何
- 地方口音能不能理解
- 數學與推理能力如何
- 翻譯品質如何
同一個模型完全可能:
英文可以進行複雜推理,但換到另一種低資源語言後只剩下簡單聊天能力。
所以未來真正成熟的多語言AI指標,不應該只比:
語言清單有多長。
而要開始比:
每一種語言到底做得有多好。
AI語言落差甚至可能放大教育差距:都有AI,但一個拿到頂級家教、一個拿到弱化版本
想像兩個學生。
A學生可以直接使用模型最擅長的語言提問。
AI可以幫他:
- 解釋數學
- 修改作文
- 模擬老師
- 設計練習題
- 解釋錯誤步驟
B學生只能使用模型資料不足的母語。
結果可能是:
- 回答不自然
- 經常誤解問題
- 知識覆蓋較少
- 必須自己先翻成第二語言
表面上兩個學生都有AI,實際上卻拿到兩種品質完全不同的教育工具。
這可能就是AI時代新的教育數位落差。
以前問的是:
家裡有沒有電腦?有沒有寬頻?
未來可能要多問一句:
你的母語是不是模型的一等公民?
醫療風險更高,因為AI「大概聽懂」在高風險情境裡可能根本不夠
一般聊天時,AI把一句俚語理解錯,可能只是造成笑話。
但醫療不一樣。
使用者可能透過地方語言描述:
- 疼痛位置
- 症狀持續時間
- 出血情形
- 喘不喘
- 疼痛程度
如果模型只理解大部分,但漏掉的剛好是最重要的症狀,結果就可能完全不同。
多語言AI真正難的不是讓模型「可以回話」,而是讓它在需要高度準確的事情上同樣可靠。
對台灣來說這並不遙遠:繁體中文支援成熟,不代表台語、客語與原住民族語能力完全一樣
台灣的日常語言環境其實非常多元。
包括:
- 華語
- 台語
- 客語
- 原住民族語
- 越南語
- 印尼語
- 泰語
- 菲律賓語言
大型AI目前對繁體中文已有相對成熟支援。
但這不能直接推論:
台語語音、客語不同腔調、原住民族語,也都擁有和繁體中文完全相同的辨識、推理與語音能力。
特別是語音情境。
台語本身就可能出現:
- 不同腔口
- 華台混用
- 大量口語詞
如果訓練資料不足,就可能出現一個很典型的情況:
AI看得懂中文字,卻不一定聽得懂阿公阿嬤真正怎麼講。
這對台灣高齡照護尤其重要,因為最需要服務的人可能剛好最不習慣打字
如果未來AI進入:
- 醫療
- 長照
- 政府服務
- 生活諮詢
最需要這些服務的一群人,可能恰好是高齡者。
而他們未必最習慣:
- 打長段文字
- 操作複雜App
- 閱讀大量選單
真正自然的入口可能就是直接開口問。
如果語音AI能理解地方語言、混合語言與不同口音,它改變的就不只是翻譯,而是誰第一次真正能使用數位服務。
但34億人的5年目標,不能被誤讀成「5年後7000種語言全部和英文一樣強」
這次共同承諾的確設定了一個非常大的目標:
未來5年,讓估計34億名使用目前AI代表性不足語言的人,更能用自己的語言與聲音使用AI工具。
但這不代表:
- 全球7,000種語言全部都會達到英文同等能力
- 所有語言會在同一時間完成
- 所有任務都能達到相同準確度
因為不同語言的:
- 使用人口
- 數位資料量
- 書寫系統
- 語音資料
- 文化背景
差異都非常大。
而且官方也明確表示,聯盟更詳細的治理架構、工作分工及工作流程,仍將在未來一年共同發展。
因此34億應理解為全球共同目標,而不是已經完成的技術成果。
真正值得注意的是,彼此競爭的AI公司也開始承認:語言資料有一部分需要成為公共基礎設施
這次60個簽署組織的名單很有意思。
裡面同時存在:
- Microsoft
- Amazon
- Anthropic
- NVIDIA
- OpenAI Foundation
- Mistral
- ElevenLabs
- Mozilla Data Collective
- 政府與研究組織
這些企業原本就在競爭:
- 模型
- 雲端
- 晶片
- 語音
- AI產品
但在低資源語言問題上,如果每家公司都從零開始替數千種語言重新收集資料,效率非常有限。
網路時代需要共同通訊標準,AI時代可能也需要共同的語言基礎設施。
下一場AI競爭不只是「誰會更多語言」,而是誰真的理解人在這個語言裡怎麼生活
早期的AI翻譯比較像:
一句英文換成一句中文。
但真正成熟的多語言AI還要理解:
- 這個說法在當地是否禮貌
- 哪些詞通常是長輩使用
- 哪些說法屬於年輕人的口語
- 一句話是不是在諷刺
- 疾病在當地怎麼稱呼
- 作物在地方上真正叫什麼名字
- 某些問題在文化上應該怎麼問
這就是:
「翻譯一種語言」和「理解一種語言背後的世界」的差別。
34億人的AI語言落差,最後其實不是翻譯問題,而是誰有資格真正進入下一代數位世界
網際網路時代最典型的數位落差曾經是:
誰沒有電腦?
↓
誰沒有寬頻?
↓
誰沒有智慧型手機與行動網路?
到了AI時代,新的問題可能變成:
你明明有手機、有網路,也能打開AI,但AI對你的母語資料不足、語音聽不懂、文化脈絡不了解,最後給你的答案品質還是比較差。
這時候,技術上你確實:
「可以使用AI。」
但實際得到的工具,卻不一定和主流語言使用者一樣。
這正是這次60個組織共同承諾真正值得關注的地方。
AI普及未來不能只看:
- 帳戶數
- 下載量
- 模型參數
- GPU數量
還要開始問一個更基礎的問題:
當一個人第一次打開AI,他能不能不用先學會另一個人的語言,就直接說出自己的問題?
如果答案是否定的,即使模型本身再聰明,仍然會有數十億人站在AI服務的外圍。
未來真正公平的AI,可能不是要求全世界都學會對AI說英文,而是讓AI終於學會聽懂全世界原本就在說的話。