
 admin
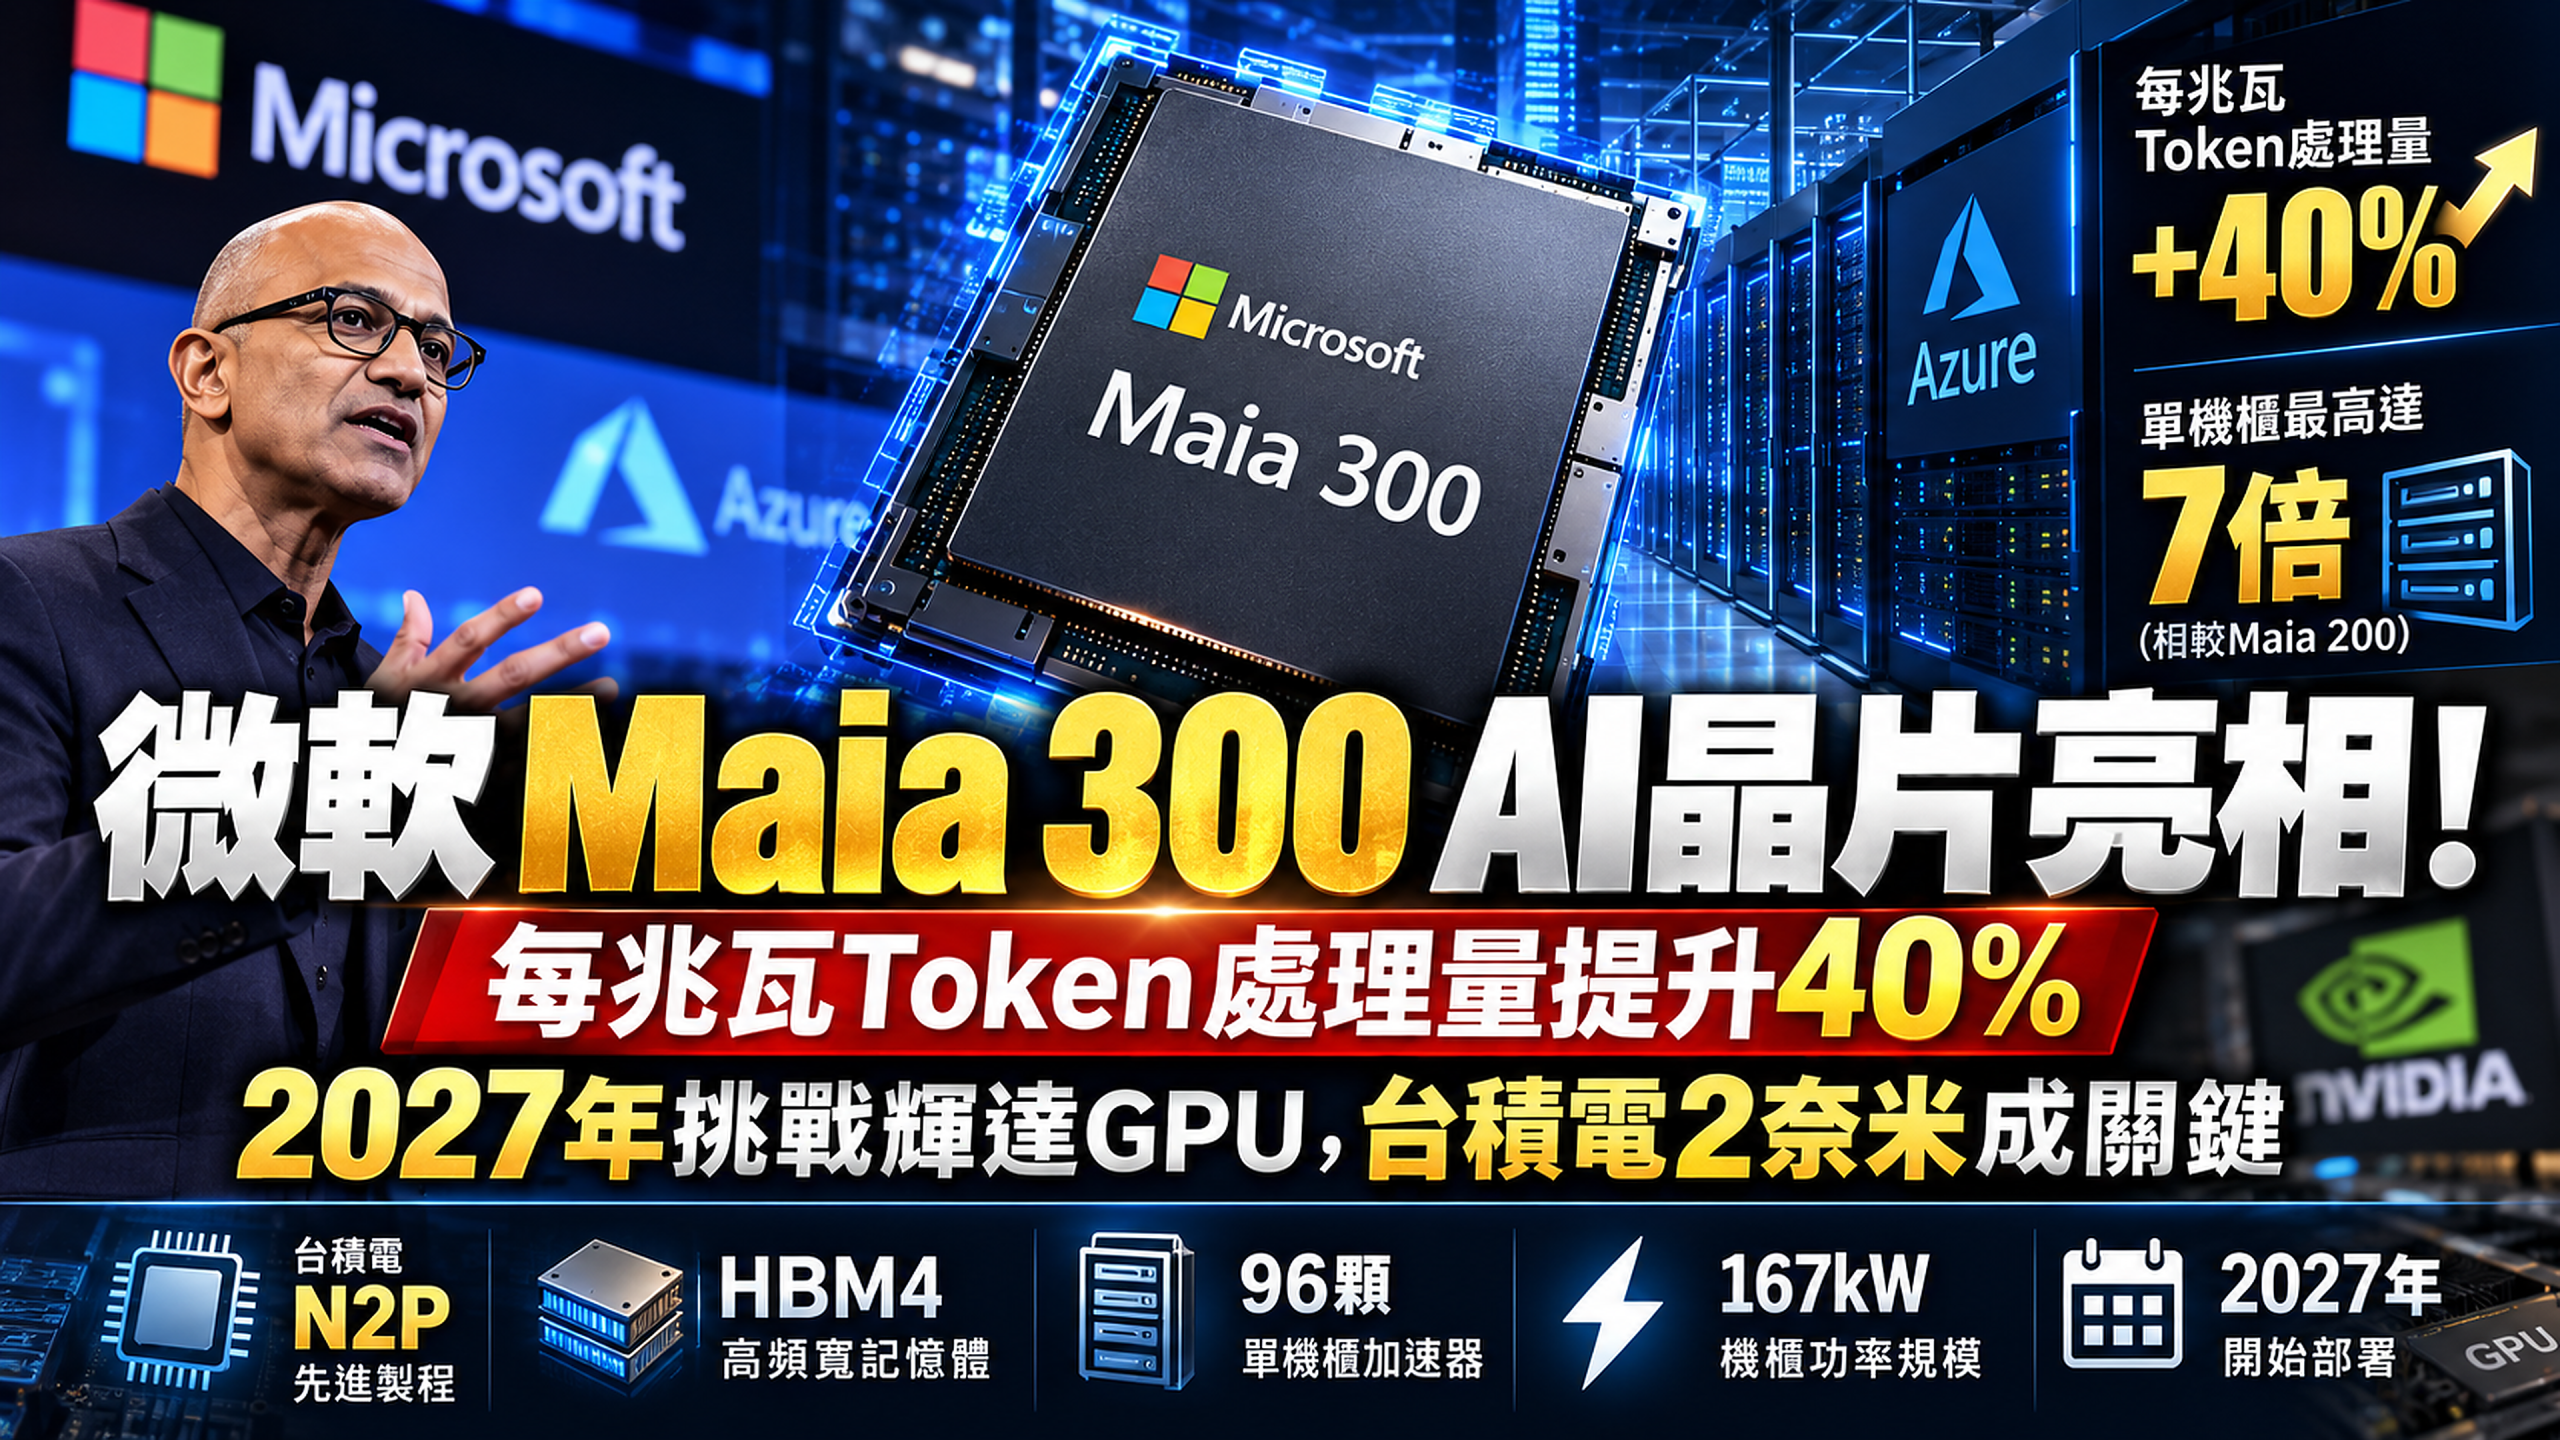
AI晶片的下一場競爭, 不是只比誰算得快。
微軟想讓同樣一兆瓦電力, 處理更多AI Token。 2027年起,將以自研加速器 改寫大型AI服務的成本結構。
比較對象為頂尖GPU系統; 不是回答速度直接提高40%。
微軟不想再只買輝達GPU!Maia 300正式亮相,2027年要成為AI服務主力
全球AI競爭正在出現一個重要轉變。
過去幾年,市場討論AI產業時, 焦點往往集中在誰擁有最多GPU、 誰能建造最大的資料中心, 以及誰能訓練出更強的模型。
但到了2026年, 另一個問題愈來愈重要: 當數億人每天使用AI助理, 誰能用更低的電力和成本, 持續提供大量AI回答?
2026年10月12日, 美國微軟正式公布 第三代自研AI加速器 Azure Maia 300, 並宣布計畫從2027年開始, 將Azure Maia系統擴大至 數GW規模部署。
台灣微軟於10月13日 公布繁體中文新聞稿, 進一步揭露相關技術細節。
微軟希望Azure Maia 逐漸成為旗下產品與服務 的主要AI推論基礎設施, 包括Copilot、 Microsoft 365相關AI功能 及其他企業級AI應用。
最受關注的, 是微軟預期Maia 300 每兆瓦電力可處理的Token數量, 較頂尖GPU系統提高40%。
此外,在96顆加速器 的完整機櫃配置下, Token處理量最高 可達前代Maia 200的7倍。
這些數字讓外界開始討論, 長期主導AI運算市場的 輝達(NVIDIA), 是否將面對更多 來自大型客戶自研晶片的競爭。
不過,這次新聞真正值得注意的, 並不是微軟已經成功淘汰輝達, 而是它正在試圖從AI晶片的大型買家, 轉變成能自行設計 核心運算系統的企業。
Maia 300有多強?微軟公布的七項關鍵技術數字
若想理解Maia 300, 不能只看單顆AI晶片效能。 微軟這次發布的主角, 其實是一套包含晶片、 記憶體、互連網路 與完整機櫃的AI推論系統。
這些規格之中, 真正有商業意義的, 不只是運算量, 而是微軟希望同時改善 晶片、記憶體、 網路及整個機櫃的效率。
因為大型AI服務的成本, 從來不只是GPU的購買價格。 還包括電力、冷卻、 設備折舊、 維運及大量AI請求 持續執行所需的資源。
如果相同供電條件下 能處理更多AI工作, 對每天提供大量AI服務 的雲端業者而言, 就可能產生長期成本優勢。
Maia 300是10月發表,還是2027年才上市?兩個日期不能混淆
這次新聞有兩個 容易被混淆的時間點。
微軟官方部落格揭露 Maia 300及未來部署策略。
台灣微軟提供完整 技術與產品規劃資訊。
微軟規劃將Azure Maia 系統擴至數GW規模。
換句話說, 2026年10月是新產品與 部署計畫的正式公布, 並非宣告現在所有Azure資料中心 都已經換裝Maia 300。
目前已經投入 實際生產環境的是Maia 200。 Maia 300還需要經歷 設備生產、系統導入, 以及大規模服務運行等階段。
因此, 討論晶片效能時, 必須將微軟公布的預期表現, 與經過實際資料中心 長期驗證的營運結果區分開來。
Maia 300到底是什麼?為什麼微軟把重點放在AI「推論」?
大型AI模型的運作, 大致包含兩個經常被提及的階段: 訓練(Training) 與推論(Inference)。
AI訓練:讓模型學會處理資訊
在訓練階段, 企業使用大量資料 及運算資源調整模型參數, 使模型逐漸具備 文字理解、推理、 程式撰寫等能力。
這個過程往往需要 大量晶片協同運算, 很重視資料傳輸 及系統擴展能力。
AI推論:使用者提出問題,模型實際產生回答
當使用者向Copilot提問、 要求AI整理文件, 或請AI Agent 執行多個工作步驟時, 模型必須讀取輸入資訊 並產生結果。 這就是推論。
如果每天有大量使用者 持續向AI發出請求, 推論成本就可能 成為龐大的長期營運支出。
| 比較項目 | AI訓練 | AI推論 |
|---|---|---|
| 主要任務 | 建立或更新模型能力 | 使用既有模型處理請求 |
| 常見情境 | 大型模型訓練、模型微調 | 聊天、文件整理、AI Agent |
| 重要指標 | 訓練吞吐量、擴展效率、完成時間 | Token處理量、延遲、每次請求成本 |
| 硬體重點 | 平行運算及高速互連 | 運算、記憶體、快取及延遲平衡 |
| Maia 300定位 | 不是此次公布的首要設計方向 | 推論優先架構 |
Maia 300的設計方向, 是針對大型語言模型 經常遇到的問題, 包括長上下文推理、 低延遲對話服務, 以及持續執行多個步驟 的AI Agent任務。
微軟將這種方式稱為 Inference-first, 意思是優先針對 推論工作負載最佳化。
這不表示Maia 300 在所有運算類型 都比通用GPU更強。 它能否發揮優勢, 仍取決於特定模型與 實際工作負載。
微軟宣稱效率提升40%,到底在比什麼?不是回答速度直接快40%
這是Maia 300新聞 最容易被誤讀的數字。
微軟使用的指標是 每兆瓦電力所能處理的 Token數量 (Tokens per Megawatt)。
Token是AI模型處理文字 及其他資訊時使用的 基本單位之一, 不完全等於一個中文字 或一個英文單字。
MW是功率單位, 1MW等於1,000kW。 若某系統在指定條件下, 每兆瓦能處理更多Token, 代表其相同供電功率 可以支援更高的運算吞吐量。
用一個例子理解40%的差異
假設某套GPU系統, 在特定模型及測試條件下, 每單位時間、每兆瓦 可以處理100萬個Token。
如果另一套系統的 每兆瓦Token處理量提高40%, 相同條件下便相當於 140萬個Token。
將比較基準設為100, 觀察提高40%後 的相對處理能力。 數值並非實際晶片測試。
僅比較相同時間及功率條件下的 相對吞吐量,不代表Copilot 回應時間縮短40%, 也不是對特定輝達產品 的獨立實測。
單位電力能處理更多Token, 不代表每個使用者 等待AI回覆的時間 都會按相同比例縮短。
實際體驗還受到 網路延遲、模型大小、 同時使用人數、 批次處理方式 與應用程式架構影響。
微軟公布的是 相較頂尖GPU系統的效能預期, 並非聲稱在所有GPU型號、 所有模型與測試條件下 都固定領先40%。
截至2026年10月14日, 這仍主要是微軟 自身公布的效能主張, 不能等同已完成 跨企業、同條件且 可完全重現的獨立測試。
7倍處理量從哪裡來?Maia 300不是單顆晶片變強7倍
除了40%的效率提升, 微軟也宣稱Maia 300 完整機櫃的Token處理量, 最高可達Maia 200的7倍。
不過, 這個比較單位是 完整機櫃(Rack-scale), 並非單顆晶片。
Maia 300完整機櫃 配置96顆AI加速器, 並整合高頻寬記憶體 與高速互連網路。
指微軟公布的 機櫃級Token吞吐量相對比較; 兩代機櫃的實際配置不同。
整櫃處理量增加, 可能同時來自 單顆加速器能力、 機櫃容納的晶片數、 記憶體頻寬、 網路架構及協同效率。
大型雲端業者 真正需要管理的, 通常不是一顆晶片跑得多快, 而是整座資料中心 可以用多少電、 同時服務多少使用者, 以及每次回答的平均成本。
Maia 200與Maia 300差在哪?微軟兩代自研AI加速器比較
Maia 200在2026年1月公布, 並已投入微軟實際工作負載。 Maia 300則是預計於2027年 開始部署的新一代架構。
| 技術指標 | Maia 200 | Maia 300 |
|---|---|---|
| 目前狀態 | 已投入生產環境 | 預計2027年部署 |
| 主要定位 | AI推論 | 新一代推論優先架構 |
| 製程 | 台積電3奈米 | 運算Chiplet採台積電N2P |
| 記憶體 | 216GB HBM3e | 8組HBM4 |
| 加速器記憶體頻寬 | 約7TB/s | 最高18TB/s |
| 完整機櫃加速器 | 前代配置 | 96顆 |
| 機櫃Token處理量 | 比較基準 | 最高約7倍 |
Maia 200資料依微軟2026年1月公告; Maia 300資料依10月新公告。 晶片與整櫃效能屬不同層級, 不應直接互相代換。
這個轉變代表微軟 希望將晶片設計、 服務模型及資料中心 作為完整系統共同最佳化, 而不是只靠更換單顆 高規格加速器提升效能。
台積電N2P、HBM4、Chiplet是什麼?Maia 300的三大技術核心
Maia 300之所以值得 台灣半導體產業關注, 是因為微軟官方 明確揭露其運算小晶片 採用台積電N2P製程。
新系統使用多Chiplet架構, 將運算、記憶體控制器 及I/O等功能分別配置, 透過系統整合 讓硬體更符合推論需求。
先進製程運算Chiplet
8組堆疊、最高18TB/s
擴展至機櫃與資料中心
減少資料搬移、改善資源利用
N2P:台積電2奈米家族的進階製程
N2P屬於台積電 2奈米技術家族的進一步演進。 對高效能AI晶片而言, 先進製程有機會改善 運算效率與功耗表現。
但製程先進, 不代表最終晶片 成本必然比較低。
實際成本還涉及 晶粒大小、良率、 封裝技術、設計複雜度 及生產數量。
HBM4:讓AI加速器更快取得資料
HBM是高頻寬記憶體 (High Bandwidth Memory) 的縮寫。
大型AI模型運作時, 除了運算能力, 也需要高速讀取 模型參數及中間資料。
如果晶片計算很快, 但記憶體供應資料的速度不足, 整體效能就可能受限。
Maia 300採用8組HBM4, 微軟公布的最高 記憶體頻寬為18TB/s, 有助於支援長上下文 與高資料吞吐工作。
Chiplet:不同功能不必都擠在同一塊晶片
Chiplet的核心概念, 是把大型系統拆成 具有不同功能的小晶片, 再透過先進整合技術協同運作。
運算單元、 記憶體控制器及I/O 能依不同技術需求設計, 提升架構彈性。
不過, Chiplet同樣會帶來 晶片間傳輸、 封裝、散熱與測試 等複雜挑戰。
MXFP4與資料流架構:減少運算之外的資源浪費
微軟也強調 強化版MXFP4等低精度格式, 以及軟體定義資料流架構。
這些設計希望減少 運算及KV快取 所需的記憶體與頻寬, 並降低資料在晶片、 記憶體和網路間反覆搬移 所產生的成本。
換句話說, Maia 300的競爭力, 不只取決於台積電製程, 也取決於微軟如何把 硬體與軟體整合成一套系統。
Maia 300會取代輝達嗎?微軟想減少依賴,不等於不再購買GPU
這是此次新聞 最受關注的商業問題。
微軟一直是全球AI基礎設施 的重要投資者, 也長期使用輝達及 其他供應商提供的加速設備。
當微軟擴大自研AI晶片使用, 的確可能使部分工作負載 不再完全依賴外部GPU。
但這不表示微軟 已宣布全面停止採購 輝達GPU。
微軟的AI服務 涵蓋不同模型、 應用及客戶需求。 部分推論工作 適合高度客製化晶片, 其他工作則可能需要 通用性較高、 軟體生態成熟的GPU。
路透社10月12日報導指出, 微軟希望透過Maia 300 改善成本結構, 並擴大自研晶片 在AI服務中的占比。
輝達的優勢不只晶片效能:CUDA、訓練市場與完整系統仍是護城河
第一,CUDA與軟體生態系不是換晶片就能取代
輝達的競爭力 不只有GPU本身, 還包括CUDA 及相關軟體工具。
許多AI開發框架、 運算程式及企業工作流程, 已經長期依賴這套生態系。
若更換平台需要重新最佳化模型、 修改軟體或增加維運成本, 客戶就不一定會只因某款晶片 理論能效更高而立即轉換。
第二,AI訓練與推論市場需求不同
Maia 300主要針對微軟自身 大規模AI推論需求。 但AI晶片市場也包含 基礎模型訓練、 科學運算、資料分析 及其他高效能運算。
即使Maia 300 在部分推論工作 取得成本優勢, 也不等於它已經全面取代 輝達在其他領域的用途。
第三,輝達具備從晶片到網路的完整系統能力
大型AI資料中心 需要的不只有運算晶片。 高速互連、 網路交換、 軟體管理、散熱 及維運能力, 都會影響整體效率。
微軟這次也把 基於乙太網路的高速互連 納入Maia 300架構, 正反映雙方競爭已經 從單顆晶片延伸到 完整AI系統。
微軟、Google、Amazon都自己做AI晶片,輝達最大的客戶正在變成競爭者?
微軟不是第一家 發展自研AI晶片 的大型雲端科技企業。
Google長期發展TPU, Amazon AWS 也推出Trainium與Inferentia 等自研晶片系列。
這些企業共同的動機之一, 是希望根據自身雲端平台 和AI服務需求, 提高效率、控制成本, 並減少對單一外部 加速運算平台的依賴。
| 公司 | AI晶片方向 | 主要策略 |
|---|---|---|
| 微軟 | Azure Maia系列 | 提高自家AI服務推論效率 |
| TPU系列 | 支援Google雲端及自家AI工作負載 | |
| Amazon AWS | Trainium、Inferentia | 分別針對AI訓練及推論 |
| 輝達 | GPU與加速運算平台 | 向多種企業及雲端客戶提供硬體與軟體 |
過去, 雲端業者主要比較 不同供應商的晶片價格與效能。
未來, 它們可能同時使用 外部GPU及自研ASIC, 依服務性質分配工作負載。
AI晶片競爭因此逐漸從 「誰製造最強GPU」, 轉變為 「誰能提供最適合成本、 模型與服務需求的運算平台」。
不過, 自研晶片仍需要 晶圓製造、先進封裝、 高頻寬記憶體及 大量工程投入, 不代表雲端公司 不再需要其他半導體供應商。
微軟Maia 300對台灣有什麼影響?台積電之外,先進封裝與散熱也受關注
Maia 300採用 台積電N2P運算Chiplet, 是微軟官方已揭露的 供應鏈技術資訊。
對台灣半導體產業而言, 全球雲端巨頭投入自研晶片, 可能帶來更多 先進製程需求。
因為雲端公司能設計晶片, 不代表它們也具備 自行生產最先進半導體 的晶圓製造能力。
晶片設計、晶圓製造、 封裝和系統整合, 仍可能由不同公司分工完成。
除了晶圓製造, Maia 300還涉及 HBM4、高密度機櫃、 電源管理、 散熱系統及高速網路。
| 產業環節 | 關聯原因 | 資訊狀態 |
|---|---|---|
| 台積電先進製程 | 運算Chiplet採N2P | 官方確認 |
| 高頻寬記憶體 | 8組HBM4整合 | 官方確認規格 |
| 先進封裝 | 多Chiplet及記憶體整合需求 | 產業技術分析 |
| 伺服器與機櫃 | 每櫃配置96顆加速器 | 官方確認規格 |
| 電源與散熱 | 167kW機櫃所需供電與熱管理 | 依技術規格分析 |
| 高速網路 | 乙太網路基礎的互連架構 | 官方確認設計 |
對產業研究來說, 最需要避免的誤判, 就是把 「需要某種技術」 直接寫成 「特定台灣公司已取得訂單」。
即使某家公司 具備AI伺服器、 散熱或封裝業務, 也不等於 它一定參與Maia 300供應鏈。
實際供應商、 訂單金額及營收貢獻, 都需要以公司或客戶 的正式資訊判斷。
一座167kW機櫃有多耗電?AI效率提高,資料中心還是可能愈來愈耗電
Maia 300完整機櫃 配置96顆AI加速器, 微軟公布的功率規模為167kW。
如果全年不間斷 維持167kW功率, 理論年度用電量為:
也就是一年約146.3萬度電。 但這是固定功率的 數學示範, 不是微軟已公開的 實際年度耗電量。
調整機櫃數量與平均負載率, 了解設備規模與年度用電的關係。
以每櫃167kW的官方功率配置 和每年8,760小時試算; 負載率是自行設定的假設。 未另外加計機房空調等 非機櫃用電及PUE, 不代表實際用電帳單。
實際年度用電量 還會受到機櫃負載率、 電源配置、 冷卻及維運條件影響。
更重要的是, 當AI晶片變得更省電, 每次回答的成本 可能下降; 但如果AI使用者、 AI Agent工作量 與整體服務需求快速增加, 資料中心總耗電量 仍可能同步上升。
所以, 單位運算效率改善 與整體電力需求增加, 並不互相矛盾。
微軟特別強調 每兆瓦Token處理量, 也正反映AI產業 已把電力視為 核心營運成本之一。
Maia 300會讓Copilot變快、變便宜嗎?一般使用者現在感受得到嗎?
對一般使用者而言, 最直接的問題可能是: Maia 300投入服務後, 每天使用的Copilot 是否會變快?
從技術上來說, 若微軟確實提高推論效率, 就可能增加同一套資料中心 可以服務的AI請求數量。
如果減少運算瓶頸, 某些對延遲敏感的工作, 也可能獲得改善。
但是, 實際使用體驗 不會完全由晶片決定。
模型能力、 同時使用人數、 網路連線、 訂閱方案、 軟體設計與資源分配, 都會影響最終速度。
更重要的是, Maia 300預計2027年 才開始正式部署。
因此, 不能聲稱2026年10月 的Copilot服務 已經因Maia 300全面加速, 也不能因此預告 Microsoft 365或Copilot 訂閱價格一定下調。
微軟目前公開的是 新一代運算架構、 效率目標及部署規劃, 並未據此宣布 所有相關服務 的統一降價方案。
Maia 200已開始運作,Maia 300為什麼還要等到2027年?
微軟官方表示, Maia 200已在美國、 歐洲及澳洲的生產環境部署, 並開始支援Microsoft Copilot 等實際工作負載。
微軟也規劃進一步 將GitHub Copilot、 Microsoft Foundry 的相關工作導入Maia架構。
至於Maia 300, 新一代多Chiplet設計、 HBM4、 高速互連與完整機櫃系統, 需要晶片製造、 軟體工具、 網路架構 及資料中心環境共同配合。
微軟強調, 軟硬體團隊在晶片開發早期 就協同設計, 使產品更符合 實際AI服務需求。
因此, 2027年不只是單純 「晶片開始出貨」, 而是整套系統 預計逐步進入 正式生產環境的時間點。
大規模部署後 是否能達到預期能效、 成本與吞吐表現, 仍須等待真實工作負載 與長期營運驗證。
微軟Maia 300常見問題FAQ
Q1:Maia 300是什麼?
Maia 300是微軟第三代自研AI加速器,屬於Azure Maia系列,主要針對大型AI模型推論、長上下文及多步驟AI Agent運算設計。
Q2:Maia 300什麼時候正式發表?
微軟美國官方於2026年10月12日公布,台灣微軟10月13日發布繁體中文資訊。
Q3:Maia 300什麼時候正式部署?
微軟規劃於2027年開始生產部署,並擴大Azure Maia系統在自家AI服務中的使用規模。
Q4:Maia 300是輝達製造的嗎?
不是。Maia 300是微軟自研AI加速器,與輝達GPU屬於不同產品平台。
Q5:Maia 300採用台積電幾奈米製程?
微軟官方揭露,Maia 300的運算Chiplet採用台積電N2P製程,屬於2奈米製程家族。
Q6:Maia 300比輝達GPU快40%是真的嗎?
微軟預期其每兆瓦Token處理量較頂尖GPU系統提高40%,但這不是所有工作負載的回答速度都加快40%,也不是已獨立證實的普遍效能結論。
Q7:Maia 300比Maia 200強7倍嗎?
微軟表示,在完整96顆加速器配置下,Maia 300機櫃級Token處理量最高可達Maia 200的7倍,不代表單顆晶片效能固定提升7倍。
Q8:Maia 300使用哪一種記憶體?
採用8組HBM4高頻寬記憶體,微軟公布最高記憶體頻寬為18TB/s。
Q9:Maia 300一顆晶片耗電多少?
微軟公布的加速器熱設計功耗為950W。TDP屬於設計數值,不能直接當成所有實際運作情況的功耗。
Q10:Maia 300一個機櫃有幾顆AI晶片?
完整機櫃配置96顆AI加速器,微軟公布的功率配置為167kW。
Q11:微軟有了Maia 300,就不再需要輝達嗎?
不能這樣認定。微軟仍有不同AI工作負載與運算需求,自研晶片與外部GPU可能長期並存。
Q12:Maia 300主要負責AI訓練還是推論?
這次產品定位以AI推論為優先,強調長上下文、低延遲互動及多步驟AI Agent工作。
Q13:Maia 300能讓Copilot回答更快嗎?
長期可能改善部分AI服務效率,但使用者感受到的速度還取決於模型、軟體、網路與實際部署,無法保證固定加速幅度。
Q14:Maia 300推出後,Copilot會降價嗎?
微軟尚未因此次晶片公布而承諾Copilot全面降價。運算成本下降不必然直接轉化成訂閱價格降低。
Q15:Maia 300對台積電有什麼影響?
Maia 300運算Chiplet採台積電N2P製程,反映雲端業者自研晶片持續需要先進晶圓製造;實際訂單與營收貢獻仍須以正式資訊判斷。
Q16:Maia 300會讓AI資料中心更省電嗎?
微軟目標是提高每單位電力可處理的AI工作量;但如果總需求快速增加,整座資料中心的用電量仍可能上升。
Q17:Maia 300會直接賣給一般消費者嗎?
目前公布的是Azure Maia系統及微軟AI服務部署計畫,並非一般消費者可購買的桌上型顯示卡。
Q18:Maia 300會取代所有Azure GPU嗎?
目前沒有這項正式公告。Azure仍支援不同企業、模型與軟體工作負載,不能將Maia視為所有GPU服務的全面替代品。
結論:Maia 300真正挑戰的不是某一張GPU,而是整個AI運算成本結構
2026年10月12日, 微軟正式公布 第三代AI晶片Maia 300, 並計畫從2027年起 將Azure Maia系統 擴展至數GW規模。
這次技術公布中 最受關注的是, 每兆瓦Token處理量 預期較頂尖GPU系統提高40%, 以及96顆加速器完整機櫃 的Token處理量, 最高達前代7倍。
台積電N2P製程、 HBM4記憶體與 多Chiplet架構, 也再次凸顯AI競爭 正朝向晶片、記憶體、 網路及資料中心的 整體設計發展。
對微軟而言, 自研晶片有機會降低 部分AI服務的長期運算成本, 並減少對單一外部 晶片平台的依賴。
對輝達而言, 挑戰是越來越多大型客戶 開始發展自己的運算架構, 部分推論工作 可能改由自家晶片承擔。
但這不代表輝達 已失去市場主導地位。 軟體生態系、 訓練需求、 系統整合及多元客戶基礎, 仍是其重要競爭優勢。
Maia 300能否在大規模部署後 實現微軟的預期, 也必須等待2027年之後 的實際營運驗證。
對台灣而言, 雲端業者即使開始自行設計AI晶片, 仍需要先進晶圓製造、 記憶體、封裝 與完整資料中心供應鏈支持。
微軟Maia 300主要官方技術與新聞資料來源
- The Official Microsoft Blog|Azure Maia系統擴大至數GW的正式公告
- 台灣微軟|Maia 300繁體中文官方新聞稿
- Microsoft Azure Blog|Maia 300架構技術說明
- The Official Microsoft Blog|Maia 200架構與HBM3e規格
- Reuters|微軟擴大自研AI晶片部署與成本策略
- Microsoft Source EMEA|Maia 300產品發表摘要
本篇以微軟10月12日英文官方公告、 10月13日繁體中文新聞稿 及Azure技術文章為主要依據。 40%是預期每兆瓦Token處理量差異; 7倍為完整機櫃級吞吐量比較; N2P指運算Chiplet採用的製程。 2027年是預計開始生產部署的時間, 不代表2026年10月已全面上線。 機櫃年度用電數字屬假設試算, 不等於微軟真實營運用電。 台灣供應鏈分析也不代表 已確認特定廠商取得訂單。