
 admin
華為AI晶片挑戰Nvidia?Ascend、百萬NPU、晶片互連與CUDA競爭一次看
AI晶片戰過去最容易比較的是:
- 哪一顆GPU跑分最高
- 哪一代製程最先進
- 誰的FP8、FP4算力更高
但當大型AI模型開始使用數千、數萬,甚至更大規模的加速器共同訓練時,真正決定整體AI算力的問題正在改變。
未來真正重要的,可能不只是「哪一顆晶片最快」,而是幾十萬顆晶片能不能像一台機器一樣工作。
華為最新更新Ascend AI晶片與大型AI基礎設施路線圖,除了規劃2027年推出Ascend 960DT與960PR,後續Ascend 970、980持續更新之外,也把SuperPoD、SuperCluster、UnifiedBus與百萬NPU級互連放到了整場競爭的核心。
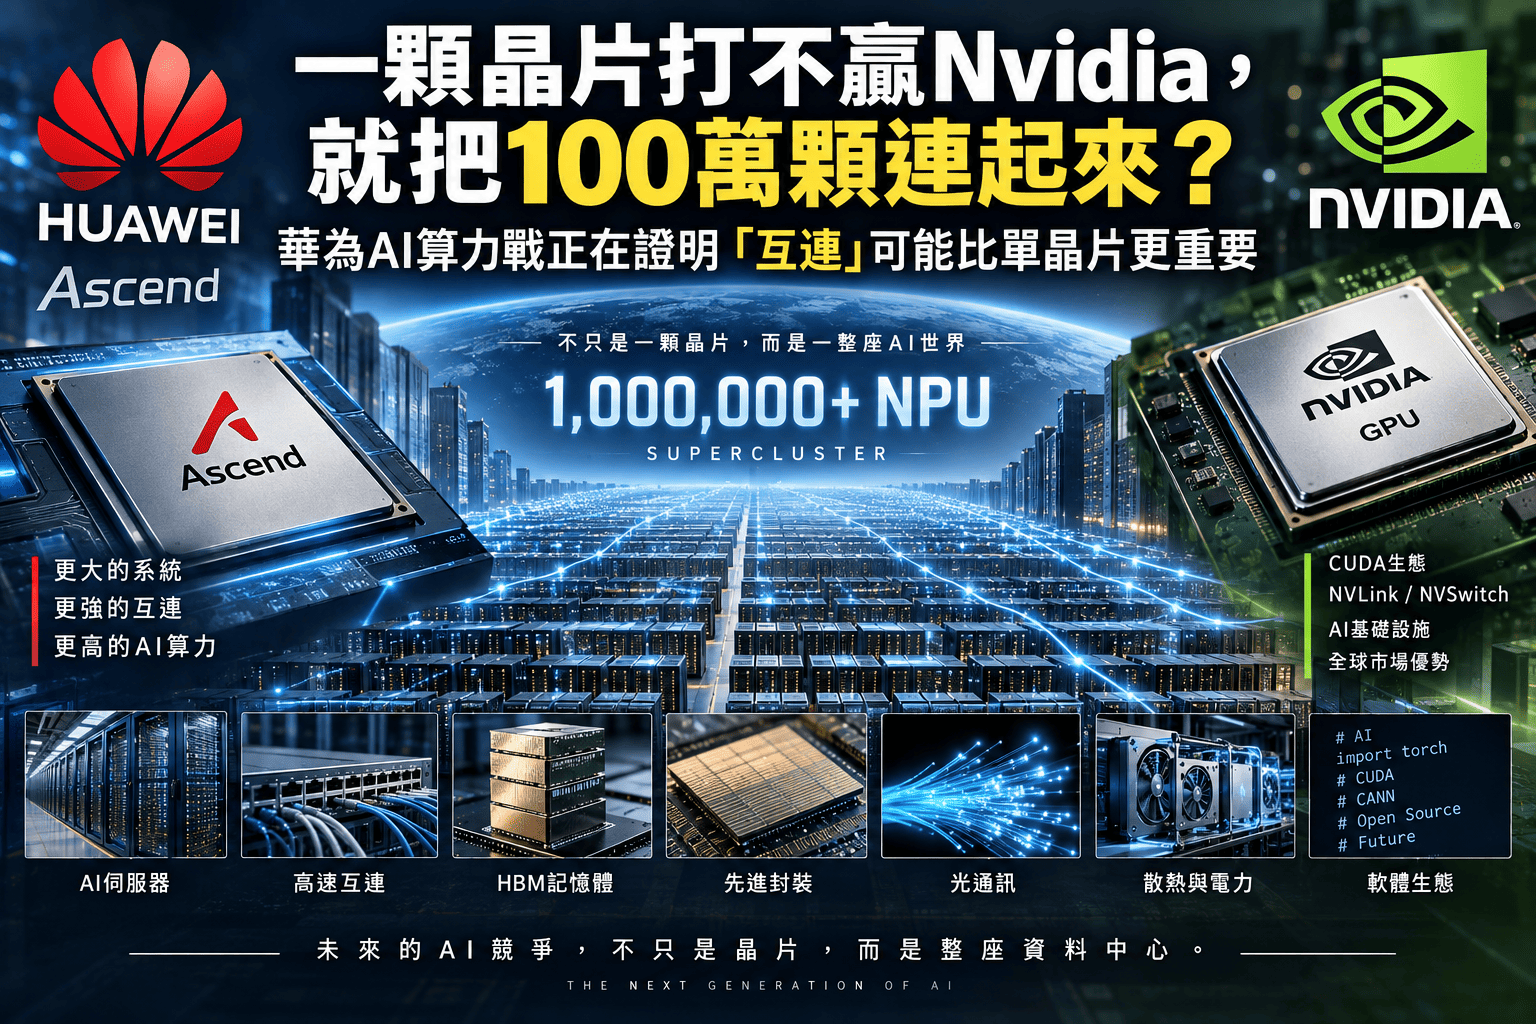
華為真正想說的,不是「我有一顆新AI晶片」,而是「我要把100萬顆晶片變成一台電腦」
華為公布的新一代Ascend路線圖中,訓練導向的Ascend 960DT預計於2027年第一季推出,推論導向的960PR則規劃在2027年第三季登場,後續Ascend 970與980預計在2028、2029年持續更新。
但如果只把這則新聞理解成:
「華為又推出一代新AI晶片。」
其實會漏掉更重要的部分。
華為真正強調的是如何把:
- AI處理器
- 記憶體
- 高速互連
- 儲存
- 網路
- 系統管理
全部串成一個更大型的計算系統。
華為這次真正挑戰的,不只是單顆GPU性能,而是「多大規模的晶片叢集可以有效率地協同工作」。
Atlas 950、Atlas 960一路擴大,華為正在把AI競爭推向「百萬NPU」
華為先前公布的Atlas 950 SuperCluster規劃,曾提出整合超過52萬顆Ascend 950DT的超大型叢集構想。
而在2026年最新Peerium Computing Architecture與SuperCluster進展中,華為進一步表示,25.6萬卡規模的Atlas 950 SuperCluster已進入部署,同時以Ascend 960、UnifiedBus與近封裝光學等架構,把大型叢集進一步推向最高約100萬顆NPU的規模。
先前公布的Atlas 960 SuperCluster目標規格則曾提出:
- 超過100萬顆NPU
- 2 ZFLOPS FP8
- 4 ZFLOPS FP4
「100萬顆」真正值得注意的,不是數字本身有多驚人,而是系統能不能讓這100萬顆處理器不斷互相等資料。
為什麼把更多晶片連起來,可以彌補部分單晶片差距?
因為今天的大型語言模型,本來就不可能只靠一顆GPU或NPU完成訓練。
模型規模越大,就需要把工作拆到更多加速器上。
例如大型模型訓練時,系統可能必須同時處理:
- 模型參數
- 訓練資料
- 梯度計算
- 中間運算結果
- 模型平行與資料平行
問題是工作一旦被拆散,就會出現另一個瓶頸:
晶片之間必須不斷交換資料。
晶片很快、網路很慢,最後可能只是「算完之後一起等資料」
假設一個模型被拆到1,000顆AI加速器。
每一顆晶片算完自己的部分後,可能都需要把結果傳給其他晶片,才能進入下一輪計算。
如果晶片本身非常快,但交換資料的速度跟不上,就可能變成:
- 處理器快速完成自己的工作
- 等待其他節點資料
- 等待同步
- 大量計算資源暫時閒置
AI資料中心真正的性能,從來不只是晶片峰值算力,而是整個系統到底有多少時間真的在運算。
所以AI算力真正要一起看的,至少有6個東西
| 項目 | 影響 |
|---|---|
| 晶片峰值算力 | 單一處理器理論運算能力 |
| 記憶體頻寬 | 資料能多快送進運算核心 |
| 晶片互連 | 多顆加速器之間交換資料速度 |
| 網路延遲 | 節點同步等待時間 |
| 儲存系統 | 訓練資料與checkpoint讀寫速度 |
| 軟體與排程 | 如何把硬體真正轉成有效算力 |
Nvidia自己也在瘋狂做互連,所以這不是華為獨有的策略
如果把華為強調互連理解成:
「因為單晶片不夠強,所以只能堆很多顆。」
其實也不完整。
因為Nvidia同樣投入大量資源開發NVLink、NVSwitch與各種高速網路技術。
它們的目的同樣是:
- 提高GPU對GPU頻寬
- 降低延遲
- 讓更多GPU以更高效率協同運算
華為現在強調互連,不代表Nvidia不重視互連,而是整個AI產業都已經進入「系統競爭」階段。
對華為而言,系統工程特別重要,因為單晶片受限後,架構就是另一個可以補差距的戰場
華為面對的現實背景非常明確。
多年來的美國出口限制,讓中國取得最先進AI加速器、製造設備與部分半導體技術受到限制。
如果單顆華為AI晶片在以下項目暫時無法全面追平最頂級競爭產品:
- 先進製程
- 每瓦效能
- HBM頻寬
- 先進封裝
- 軟體成熟度
另一條路就是利用:
- 更多晶片
- 更密集互連
- 更大的叢集
- 更有效率的排程
去提高整體有效算力。
單一處理器不是世界最快,不代表一整座資料中心不能透過系統工程提升競爭力。
UnifiedBus、SuperPoD、SuperCluster到底在解決什麼?
華為現在大量談UnifiedBus、SuperPoD與SuperCluster,本質上都是同一個問題:
怎麼讓大量CPU、NPU、記憶體、SSD、NIC與交換器,盡量像同一台機器裡的元件一樣溝通。
UnifiedBus的概念,就是把運算、儲存與網路之間的互連整合進統一架構,降低不同元件之間溝通的障礙。
而SuperPoD則更接近把大量AI處理器組成超大型運算節點,再由多個SuperPoD形成更大的SuperCluster。
但「100萬顆晶片」聽起來很猛,真正難的是通訊、耗電與故障率
大型叢集並不是晶片數量增加10倍,性能就自動增加10倍。
第一個問題:通訊成本
晶片越多,需要交換的資料越多。
如果晶片互連頻寬跟不上,或網路延遲過高,大量AI處理器就會把時間浪費在等待同步。
第二個問題:故障率
一台伺服器發生故障可能不常見。
但如果整個系統包含:
- 幾十萬顆甚至更多處理器
- 數千到上萬個機櫃
- 大量交換器
- 光模組
- 記憶體
- 儲存設備
硬體故障就不再是「意外」,而可能變成日常營運條件。
第三個問題:電力
處理器越多,功耗就越高。
百萬NPU系統真正的挑戰不是「有沒有100萬顆」,而是怎麼讓100萬顆晶片值得它們消耗的每一度電。
大型AI叢集真正需要的,是一整套「故障當日常」的系統設計
規模走到數十萬顆晶片後,系統就必須具備:
- 故障隔離
- 自動重新排程
- 容錯機制
- 斷點續訓
- 網路故障重新路由
- 即時硬體監控
這也說明AI競爭其實已同時變成:
| 晶片戰 | 誰能做出更高效能的AI處理器 |
| 網路戰 | 誰能讓更多處理器高速互連 |
| 電力戰 | 誰能取得足夠、穩定且便宜的電力 |
| 散熱戰 | 誰能有效帶走高密度機櫃產生的熱 |
HBM為什麼突然這麼重要?因為AI晶片很多時候不是「算不動」,而是「餵不飽」
AI硬體新聞很容易只看TOPS、TFLOPS、FP8或FP4。
但處理器就算計算能力非常強,如果資料無法快速送進核心,仍然會浪費運算能力。
這也是HBM,也就是High Bandwidth Memory高頻寬記憶體,成為AI產業關鍵零組件的原因。
大型模型運算過程中,需要不斷:
- 讀取模型參數
- 寫入中間結果
- 搬移資料
- 同步不同處理器狀態
AI晶片真正的問題有時不是「核心算得不夠快」,而是記憶體來不及把資料餵給核心。
所以以後看AI晶片新聞,不能再只看幾奈米和核心數
未來評估AI加速器,至少還要一起看:
- HBM容量
- 記憶體頻寬
- GPU/NPU互連頻寬
- 封裝方式
- 網路架構
AI加速器正在從「一顆晶片」,變成運算+記憶體+互連+封裝共同組成的模組。
先進封裝也因此變成AI戰場:不是只把晶片做小,而是把不同晶片放得夠近
當AI系統需要更高速傳輸時,一個非常直接的方法,就是縮短需要互相交換資料的元件距離。
因此近年這些技術的重要性快速上升:
- Chiplet
- 2.5D封裝
- 3D封裝
- CoWoS等先進封裝架構
- 近封裝光學
華為這次公布的Ascend 960 SuperPoD也特別強調NPO,也就是Near-Packaged Optics近封裝光學。
AI硬體競爭正在從「把每一顆晶片做得更快」,進一步變成「如何重新安排所有元件的物理距離」。
為什麼光通訊也被捲進AI熱潮?因為電訊號跑得越遠,功耗與延遲越難控制
當資料中心規模變得越來越大,傳統電氣互連會面臨更嚴格的:
- 功耗
- 訊號完整性
- 延遲
- 散熱
因此光學互連開始逐漸靠近計算晶片與交換器。
這也是為什麼AI產業熱潮同時把:
- 晶圓代工
- HBM供應商
- 封裝廠
- 交換器廠商
- 光通訊供應商
全部拉進同一條供應鏈。
但華為最難追的,可能還不只是硬體,而是Nvidia花了多年建立的CUDA
如果只比較硬體規格,很容易低估Nvidia真正的護城河。
Nvidia真正強大的地方不只GPU,還包括:
CUDA生態系。
CUDA不是單純一個程式語言介面。
它背後還包含大量:
- 編譯器
- 函式庫
- 除錯工具
- 效能最佳化工具
- AI與HPC軟體
- 大量開發文件與社群經驗
企業真正難的不是「買另一張卡」,而是整套程式要不要跟著搬家
假設一家AI公司原本全部建立在Nvidia與CUDA上,現在要換成其他硬體平台,真正需要面對的是:
- 原有程式是否需要修改
- PyTorch等框架支援是否完整
- 工程師是否熟悉新平台
- 效能最佳化工具是否成熟
- 第三方函式庫是否可直接使用
- 遇到問題是否容易找到文件與答案
換一顆AI晶片是一筆硬體採購,換掉CUDA則可能是一場軟體遷移工程。
華為因此不能只做Ascend,還必須同時做軟體生態
這也是為什麼華為近年除了Ascend硬體,也持續投入:
- CANN
- 編譯器
- 函式庫
- AI框架支援
- 開發工具
- 開發者社群
華為2026年也持續強調CANN開源以及Ascend對主流開源AI專案與PyTorch後端的支援。
硬體做出來可能需要幾年,但讓數百萬工程師願意使用一套平台,往往需要更長時間。
中國市場為什麼仍可能讓Ascend快速長大?因為「買不到首選」本身就會創造替代動機
在正常市場環境下,開發者通常沒有太大動機離開已經成熟的工具。
但中國AI市場的特殊情況在於,高階Nvidia產品受到出口政策與供應限制影響。
因此中國:
- 雲端服務商
- AI模型公司
- 研究單位
- 大型企業
都會產生更強的誘因去適應Ascend或其他中國AI加速器。
華為也表示,目前中國國內對AI算力設備的需求仍超過其供應能力,並限制其進一步向海外擴張。
替代生態怎麼長出來?不是先有完美軟體,而是先有人被迫天天用
一套替代軟體平台真正開始成熟,通常會經歷:
- 更多企業開始使用
- 更多Bug被發現
- 更多Bug被修正
- 更多最佳化工具出現
- 更多文件與案例累積
- 更多工程師熟悉平台
CUDA的護城河仍然深,但只要大量使用者長期被導向另一套平台,替代生態就有機會開始自我強化。
華為和Nvidia真正的競爭,可能不是誰把誰打倒,而是全球開始出現兩套AI技術棧
Nvidia目前在全球AI加速運算市場仍有非常明顯的硬體與軟體生態優勢。
但中國正在逐步建立另一套完整AI基礎設施:
- 晶片
- AI伺服器
- 互連
- 儲存
- 軟體
- 模型
- 雲端服務
| 競爭層級 | Nvidia/全球主流技術棧 | 中國自主技術棧 |
|---|---|---|
| 加速器 | Nvidia GPU | Ascend等國產AI加速器 |
| 互連 | NVLink、NVSwitch等 | UnifiedBus、SuperPoD等 |
| 軟體 | CUDA、CUDA-X | CANN等 |
| 系統 | HGX、DGX、NVL等 | Atlas、SuperCluster等 |
競爭最後可能變成:誰能定義AI資料中心的標準
如果不同市場逐漸建立不同硬體、不同軟體與不同資料中心架構,半導體競爭就會從:
「誰賣最多GPU?」
進一步變成:
「誰能定義下一代AI資料中心怎麼蓋?」
而一旦標準形成,影響通常會比單一世代晶片的性能輸贏更久。
但「一顆打不贏就堆100萬顆」也有極限,因為規模化從來不是免費的
大型叢集確實可以利用平行運算彌補部分單顆晶片差距。
但如果為了完成同樣工作,一套平台需要明顯更多晶片,就會帶來額外成本。
- 更多晶片成本
- 更多AI伺服器
- 更多交換器與光模組
- 更大機房空間
- 更高耗電
- 更多散熱需求
- 更多潛在故障點
真正的問題不是「能不能堆到100萬顆」,而是完成同樣AI工作時,需要付多少硬體、電力與營運成本。
企業真正付錢的不是峰值算力,而是每一個Token到底花多少錢
對AI基礎設施來說,最漂亮的理論跑分不一定等於最好的商業系統。
企業最終真正需要計算的是:
- 一次模型訓練要花多少錢
- 每一百萬Token推論成本多少
- 每瓦能產出多少有效算力
- 叢集平均利用率多高
- 設備故障會造成多少停機時間
峰值算力是一個規格,真正能賣錢的是有效算力。
Nvidia自己早就不只是一家賣GPU的公司
這也是理解華為現在策略最重要的一點。
Nvidia目前提供的其實已經是一整套:
- GPU
- NVLink
- NVSwitch
- 高速網路
- CUDA
- CUDA-X
- AI軟體
- 整套資料中心系統
所以華為真正正在追趕的,也不是:
「做出一張比Nvidia快的卡。」
而是Nvidia經營很久的:
Full Stack,全堆疊AI基礎設施。
這場競爭對台灣半導體產業的影響,也不只是Nvidia晶圓訂單多不多
如果AI競爭持續往系統級發展,台灣供應鏈真正需要看的範圍會越來越大。
受影響的可能包括:
- 晶圓代工
- 先進封裝
- AI伺服器
- PCB
- 高速連接器
- 交換器
- 光通訊
- 散熱
- 電源管理
- 液冷
- HBM與相關整合
當一套AI叢集從1,000顆晶片擴大到10萬、50萬甚至100萬顆,每多一層規模,都會放大網路、電力、散熱、封裝與資料傳輸需求。
未來AI產業最大的市場,可能不是「那一顆晶片」,而是把幾十萬顆晶片變成一台電腦的所有零件
這也是為什麼「互連」這個過去相對偏工程端的技術詞,正在逐漸變成AI產業核心關鍵字。
因為只要處理器數量夠多,真正限制整體性能的就不再只是核心速度。
AI算力真正的下一個戰場,是如何讓海量晶片有效率地「一起算」。
以後看AI晶片新聞,真正值得看的不只是誰宣稱算力最高
如果AI系統正在從單晶片競爭進入系統競爭,那未來看硬體規格時,可以多看幾個指標。
- 實際有效利用率多少
- 記憶體頻寬有多高
- 晶片互連頻寬與延遲多少
- 多少顆晶片能有效擴展
- 單一節點故障後系統會怎樣
- 每瓦能完成多少有效運算
- 每一美元能完成多少推論
因為一套峰值算力非常高、但大量時間都在等待資料的系統,不一定比單晶片較弱、但使用率更高的系統更划算。
所以華為真正挑戰Nvidia的,不是一顆Ascend,而是一整套AI基礎設施
Ascend 960DT、960PR最後能不能在單晶片實際性能上追近同期Nvidia產品,目前還不能提前下結論。
華為目前公布的大量性能數字,也主要來自公司自身產品路線圖與架構說明,真正實際表現仍需要等待:
- 產品正式落地
- 大規模客戶使用
- 第三方測試
- 真實訓練與推論成本比較
但有一件事已經非常明確:
AI產業的競爭單位已經變了。
過去最重要的是:
CPU、GPU、一顆晶片
現在越來越像:
整座資料中心本身,就是一台AI電腦。
未來AI算力王者,不一定只是做出全世界最快晶片的公司
華為百萬NPU SuperCluster真正值得看的,不是「100萬」這個數字本身。
而是它反映出一個越來越清楚的產業邏輯:
未來AI算力的王者,不一定只是做出最快晶片的公司,而可能是最能把幾十萬、幾百萬顆晶片協調成一台機器的公司。
這也代表接下來的AI晶片戰,真正重要的已經不只晶片本身。
互連、HBM、封裝、光通訊、軟體生態、電力與散熱,都正在逐漸成為同一場戰爭的一部分。
AI晶片下一階段真正比的,不只是誰算得最快,而是誰能把算力真正用掉。