
 admin
Apple把大型AI搬回Mac!企業為何開始算Local AI與Token成本?
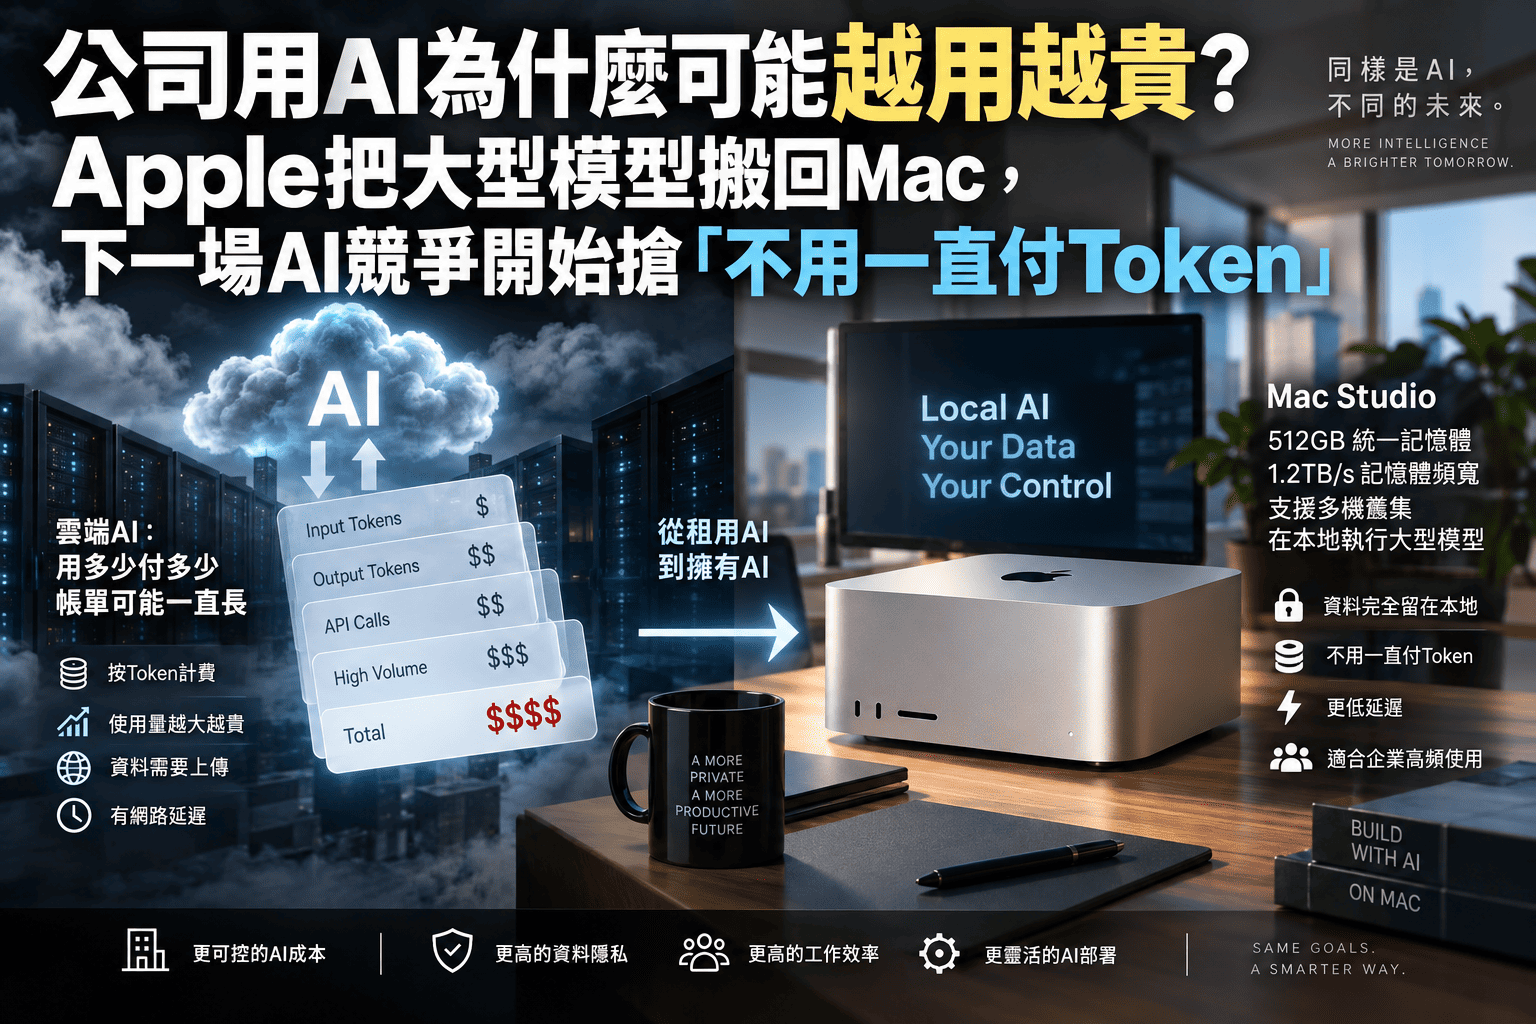
生成式AI真正開始進入公司流程後,企業很快會從「哪個模型最強」進入另一個問題:每天幾萬、幾十萬次推論到底要花多少錢?Apple正利用新一代Mac Studio與Mac mini切進這個市場,把大型模型推論直接搬到企業本地。這不代表雲端AI即將消失,而是企業開始重新計算:哪些高頻、固定又涉及敏感資料的工作值得自己跑,哪些複雜任務仍值得按Token向雲端購買最強模型。
AI真正開始進公司後,老闆很快會發現:模型用得越多,帳單可能真的一直長
過去企業導入生成式AI,最常問的問題是:
- 哪一個模型最聰明
- 哪一家推理能力最好
- 哪個AI最會寫程式
- 哪個模型上下文最長
但當AI從偶爾使用的聊天工具,逐漸變成每天都在跑的企業軟體後,問題會快速改變:
一個月到底要花多少錢?
因為許多企業不是只使用ChatGPT網頁版,而是把模型接進API、客服、內部知識庫、程式開發工具與AI Agent。
這些服務可能按照輸入Token、輸出Token、快取、模型等級與推理量計費。
員工問一次AI → 有成本
AI讀一份長文件 → 有成本
客服回覆1萬名客戶 → 有成本
AI Agent全天候重複讀檔、搜尋與呼叫工具 → 成本可能更快累積
Token到底是什麼?公司AI帳單不是單純算「問了幾次」
大型語言模型會先把文字拆成Token,也就是模型實際處理資訊時使用的基本單位。
所以當企業把100頁合約、整個程式專案或大量公司文件交給AI時,真正計算的不是「問了一題」,而是有多少內容被送進模型,又產生多少內容。
例如2026年9月推出的Claude Opus 5.5,API標準價格為每100萬Input Token 4美元、每100萬Output Token 20美元。
真正影響企業的往往不是單次API很貴,而是同樣的AI流程每天執行數萬、數十萬甚至更多次。
AI Agent普及後,Token成本可能比聊天機器人長得更快
傳統聊天機器人通常是:
人問一次 → AI回答一次
但AI Agent可能自行:
規劃任務
↓
搜尋資料
↓
讀取文件
↓
呼叫工具
↓
檢查結果
↓
失敗後重新執行
使用者表面只下達一個命令,背後卻可能觸發幾十次模型呼叫。
當AI從聊天工具變成24小時運作的軟體勞動力,Token就開始從小額服務費變成真正的營運成本。
Apple現在給企業的答案很直接:既然每天都要跑,為什麼不把一部分算力買回公司?
Apple新一代Mac Studio把企業Local AI推到一個以前桌上型工作站很少碰到的規模。
搭載M5 Ultra的Mac Studio最高支援:
- 512GB統一記憶體
- 1.2TB/s統一記憶體頻寬
- 最高36核心CPU
- 最高80核心GPU
- Thunderbolt 5
- RDMA多機叢集
Apple甚至直接在官方產品說明中強調,使用者可以完全在裝置端執行大型模型,不必每次計算Token,也不必持續承擔雲端推論成本。
4台Mac Studio可以組AI叢集,但這不等於辦公室可以自己訓練下一個GPT
新Mac Studio可以透過Thunderbolt 5與RDMA,把多部Mac串成分散式AI運算叢集。
Apple表示,4台Mac Studio組成的叢集,在特定分散式AI推論工作上最高可達單台約3倍效能,Reuters也報導Apple展示使用4台Mac Studio執行兆級參數模型。
但這裡一定要分清楚:
| 階段 | 主要工作 | 資源需求 |
|---|---|---|
| Training 訓練 | 讓模型從龐大資料中學習 | 大量GPU、網路、儲存、電力與資料中心 |
| Inference 推論 | 用已經訓練好的模型回答問題、摘要、寫程式或分析資料 | 依模型大小與工作量而定,本地工作站已有能力處理部分大型模型 |
Apple這波真正主打的是把更多「推論」工作搬回企業,而不是讓幾台Mac取代大型AI訓練資料中心。
Apple Silicon打Local AI的關鍵不只是GPU,而是超大的統一記憶體
大型語言模型有一個非常直接的硬體問題:吃記憶體。
模型參數越多、精度越高,需要載入記憶體的資料也越大。
Apple Silicon採用Unified Memory架構,CPU、GPU與其他運算單元使用同一個大型記憶體池。
對大型Local AI模型來說,512GB統一記憶體的真正價值,是讓更多大型權重有機會直接留在一台工作站的可用記憶體環境中。
Apple真正想賣的,可能不是一台昂貴Mac,而是一張「固定成本AI年票」
Reuters指出,高階配置的新Mac價格可接近2萬美元。
乍看之下很貴。
但企業真正會比較的是:
| 雲端AI | Local AI |
|---|---|
| 使用多少付多少 | 先購買硬體 |
| 需求增加,Token費用同步增加 | 設備購入後可反覆執行推論 |
| 供應商處理硬體與模型基礎設施 | 企業自己負責設備、模型與維護 |
這本質上就是變動支出OPEX與資本支出CAPEX之間的選擇。
「不用一直付Token」不代表AI免費,只是成本結構換了位置
Local AI仍然有大量成本,包括:
- 硬體購置
- 電力
- 儲存空間
- IT維護
- 資安
- 模型部署與更新
- 設備汰換
- 工程師人力
因此不能把它簡化成「Cloud AI要花錢,Local AI免費」。真正改變的是計費模式與責任歸屬。
什麼公司最容易算出「自己跑比較划算」?通常是AI已經變成生產流程的企業
如果一家公司一天只用AI十幾次寫Email、整理摘要,購買高階Local AI設備通常沒有太大經濟意義。
真正可能比較快算出回本點的,是:
- 軟體開發公司
- 客服中心
- 企業知識庫
- 法律與大量文件分析
- 金融研究
- 醫療與研究單位
- AI Agent平台
Local AI第二個真正有力的賣點,可能根本不是價格,而是資料不用離開公司
很多企業不敢把AI大量導入,不一定是因為API太貴,而是因為資料非常敏感。
- 客戶資料
- 合約
- 未公開產品設計
- 程式碼
- 財務報表
- 研發資訊
- 醫療或受監管資料
即使雲端服務承諾不使用企業API資料訓練模型,企業仍可能必須處理資料傳輸、跨境、第三方供應商、稽核與法規問題。
對某些組織而言,最簡單的資料治理策略不是找到最可信任的外部AI,而是敏感資料根本不要離開公司環境。
第三個優勢是延遲:不必每一次都把資料送到遠端資料中心
對即時字幕、語音辨識、圖片處理、程式碼補全與內部搜尋來說,本地運算可以降低部分網路來回與外部服務延遲。
當使用者每秒都在和模型互動時,數百毫秒的差異就可能改變實際體驗。
未來公司可能真的會出現「AI同事專用Mac」
想像一台Mac Studio不是任何員工的個人桌機,而是放在公司IT部門或機房。
整家公司把:
- 客服AI
- 知識庫搜尋
- 翻譯
- 摘要
- 程式Agent
全部連到這組本地算力。
這時Mac就不再只是「個人電腦」,而更接近一座小型企業AI基礎設施。
但Local AI最大的限制也很直接:你在本地跑的模型,不一定是世界最強模型
企業直接呼叫頂尖雲端模型,通常可以立即取得最新模型能力、更大的推理資源與完整的雲端工具生態。
Local AI目前更常搭配開放權重模型、較小型模型,或經過量化的版本。
Local AI不是「免費版的最強雲端AI」,而是一種模型能力、資料隱私、延遲與成本之間的交換。
模型越大也不一定越好,企業真正需要的是「用最低成本把工作做完」
客服分類、文件標籤、內部搜尋或固定格式摘要,未必每次都需要呼叫世界最強的前沿模型。
某些任務使用較小、成本較低,甚至經過特定領域調整的模型,就可能已經足夠。
企業未來真正會問的,可能不再是「哪個AI最強」,而是「這個工作最便宜可以用哪個模型完成」。
所以企業最後很可能不是Local和Cloud二選一,而是走向Hybrid AI
最現實的企業架構很可能是:
| 工作類型 | 可能執行位置 |
|---|---|
| 文件分類、搜尋、固定摘要 | 小型本地模型 |
| 公司知識庫、敏感文件分析、程式補全 | 大型Local AI |
| 高階推理、複雜研究、特殊多模態工作 | 雲端前沿模型 |
| 高風險、高責任決策 | AI輔助+人工確認 |
平常自己處理,真的需要最強模型時再付費,可能就是企業AI版的Hybrid Cloud。
AI路由器可能成為下一個重要企業軟體:先判斷「這題值得花多少錢」
成熟的企業AI系統收到工作後,未來可能不會全部丟給同一個模型。
簡單問題 → 小型Local模型
一般工作 → 大型Local模型
困難問題 → 雲端前沿模型
高風險任務 → 人工複核
這就是Model Routing。
真正最佳化的不是「每一題都用最強模型」,而是「每一項工作用最低合理成本取得足夠好的結果」。
這場Local AI競爭當然不只有Apple,Microsoft與Nvidia仍有巨大的既有優勢
Apple雖然在硬體效率、統一記憶體與裝置端AI上找到明確切入點,但真正進入企業市場還有一個現實問題:
大多數企業桌面環境目前仍然不是Mac。
Reuters引述數據指出,Apple在企業桌面市場占比約4.6%,Windows則約91.3%。
Nvidia的優勢也不只是GPU效能,而是CUDA、開發框架、企業部署與資料中心生態系已累積多年。
因此Apple除了硬體之外,還必須持續補齊Core AI、MLX、部署工具、模型支援與企業管理能力。
對中小企業來說,Local AI最可能先落地的場景之一,就是「公司自己的知識庫」
例如律師事務所可以把過去案件、範本與合約放進公司內部系統;製造業可以放產品規格、SOP、維修紀錄與技術文件。
員工直接詢問:
「這台設備去年發生過哪些故障?當時怎麼處理?」
如果模型、向量資料庫與原始文件都部署在公司內部,就可以降低大量商業機密持續傳送到外部服務的需求。
軟體公司可能更快採用Local AI,因為程式碼同時符合「高頻、敏感、Token很多」
AI程式工具不只是讀目前這一行程式碼,而可能反覆讀取:
- 整個Repository
- 多個檔案
- 文件
- 錯誤紀錄
- 大量上下文
這代表Token量可能很大,同時程式碼又是企業最重要的智慧財產之一。
Apple也把on-device coding agents直接列為新Mac Studio的重要應用。
但Local AI最後最大的成本可能不是電,而是「公司要有人懂得維護」
買一台Mac並不難。
真正把本地模型放進企業流程,還需要處理:
- 模型選擇
- 量化
- RAG
- 權限
- 資料清理
- 監控
- 安全更新
所以企業真正該比較的是Total Cost of Ownership,總持有成本,而不是只拿Mac售價和API帳單直接相減。
AI下一場成本戰,可能不是比誰的GPU最強,而是「100萬次任務到底誰最便宜」
AI產業過去幾年一直在比:
- 更多參數
- 更大的資料中心
- 更多GPU
- 更強推理能力
但當企業真正把AI部署到每天都在運作的工作流程後,下一個階段一定會開始「算帳」。
- 同一件工作用雲端模型多少錢
- Local AI多少錢
- 小模型是否已經足夠
- 敏感資料能不能離開公司
- 硬體多久可以回本
- IT維護成本有多高
Apple真正提出的不是「Mac比所有雲端AI更聰明」,而是:如果AI已經變成每天都要使用的基礎工具,企業是不是仍要永遠按照每一次使用量付費?
對低頻AI使用者而言,答案很可能仍然是雲端最方便。
但如果一家公司每天有幾萬次AI任務、大量內部文件需要分析,又開始部署全天候AI Agent,成本模型就會完全不同。
那時候,一台已經付完硬體成本、可以重複執行模型的設備,就可能不再只是高階電腦,而是一座公司的私人AI算力站。
所以Apple現在下注的,可能不只是多賣幾台Mac。
而是一個更深的企業AI轉變:
AI正從「每次向外部服務租智慧」,逐漸變成企業開始把一部分智慧與算力直接買回自己公司。
可延伸追蹤的6個議題
- AI Token怎麼算錢?輸入Token、輸出Token與企業API帳單為什麼可能越用越高
- Local AI是什麼?本地模型和ChatGPT、Claude等雲端AI真正差在哪
- 公司自己跑AI真的比較省嗎?硬體、電費、工程師與Token成本如何一起算
- Mac Studio為什麼能跑大型語言模型?統一記憶體、GPU與512GB記憶體的作用是什麼
- 企業資料適合放進雲端AI嗎?Local AI為什麼開始受到金融、法律與研發團隊注意
- AI Agent為什麼可能讓Token帳單暴增?從聊天機器人到自動工作流程,企業AI成本如何改變